こんにちは、よだかです。
今回は、技術よりも思考寄りの話です。
ここしばらく、CEXとDEXを横断して市場を観測する仕組みを作っています。
もともとの目的はシンプルで、
CEXとDEXの価格が乖離したあと、どちらが先に動いて、どちらが後から追随しているのかを見たい
というものでした。
これまでの検証で、一定以上の価格乖離が起きたあと、再び収束する傾向自体はかなり見えてきました。
-
-
🛠️開発記録#554(2026/8/27)AIと進めていたアルゴ研究を一度止めて、研究そのものを監査した話
続きを見る
次に知りたいのは、その中身です。
たとえば、
- Binanceが先に動いてHyperliquidが追っているのか
- Hyperliquidが先に動いてBinanceが追っているのか
- 両方が中間地点へ寄っているのか
- その時間差は何秒くらいあるのか
といったことです。
そこで、従来より細かい時間粒度でBinanceとHyperliquidを観測する仕組みを作り始めました。
-
-
🛠️開発記録#550(2026/8/21)清算はどこから伝播するのか|CEX・Hyperliquid・DeFiの横断観測を始めた話
続きを見る
ところが、思わぬところで結構な時間を使うことになりました。
timestampです。
「どっちが先?」を見るには時計を合わせる必要がある
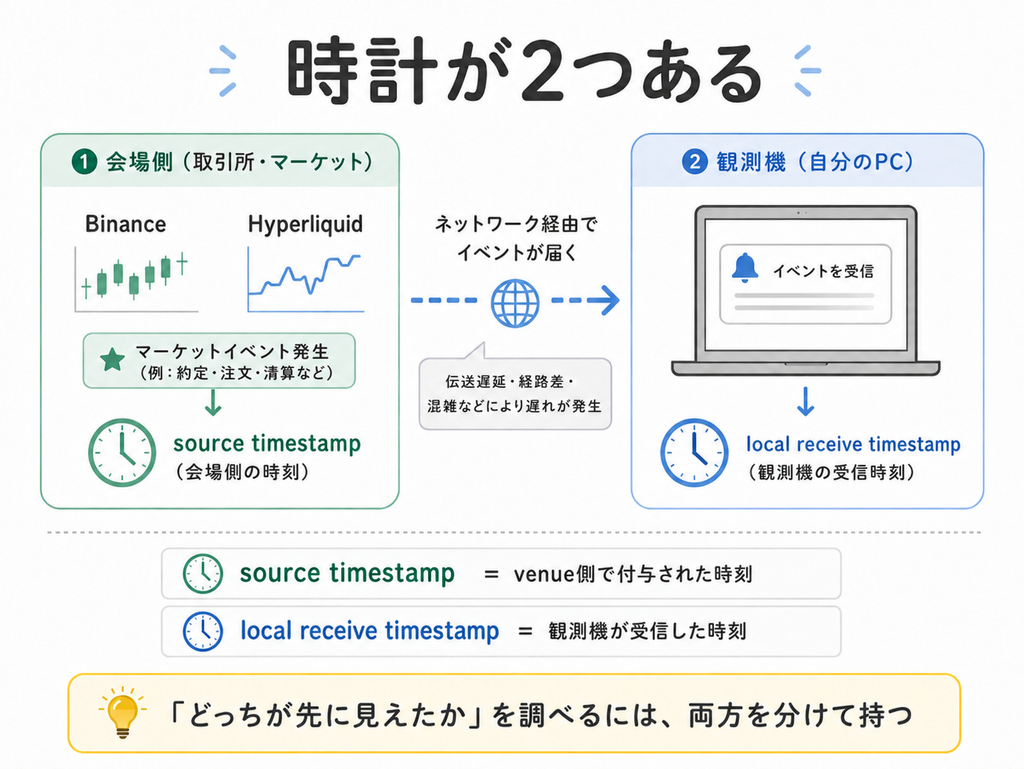
Binanceから取得したデータには、Binance側で付与されたtimestampがあります。
一方、自分のPCにも、
「このデータを何時に受信したか」
というローカル側のtimestampがあります。
当然ですが、この2つは同じ時計ではありません。
実際に観測してみると、
「ローカルで受信した時刻より、Binance側のevent timestampの方が未来になっている」
ように見えるケースがありました。
最初に見たときは、
「データ取得処理のどこかがおかしいのか?」
とも思いました。
調べていくと、Binance側の時計と自分のPCの時計には数十ms程度の差があることが分かりました。
つまり、
Binanceの時計 ≠ ローカルPCの時計
です。
それなら両者の時計のズレを測って補助的に使えばいい。
そこでBinanceのserver timeを定期的に取得して、
Binance時計とローカル時計の関係
を推定する仕組みを作りました。
Binance USDⓈ-M Futuresには、現在のserver timeを返すpublic endpoint(
GET /fapi/v1/time)があります。今回はこれを使って、Binance側とローカル側のclock relationを補助的に観測しました。
ここまでは、それほど変な話ではありません。
問題はその後でした。
時計差を推定するロジックが、存在しないズレを作った
server timeを問い合わせるときは、
ローカル
↓
Binance
↓
ローカル
という通信が発生します。
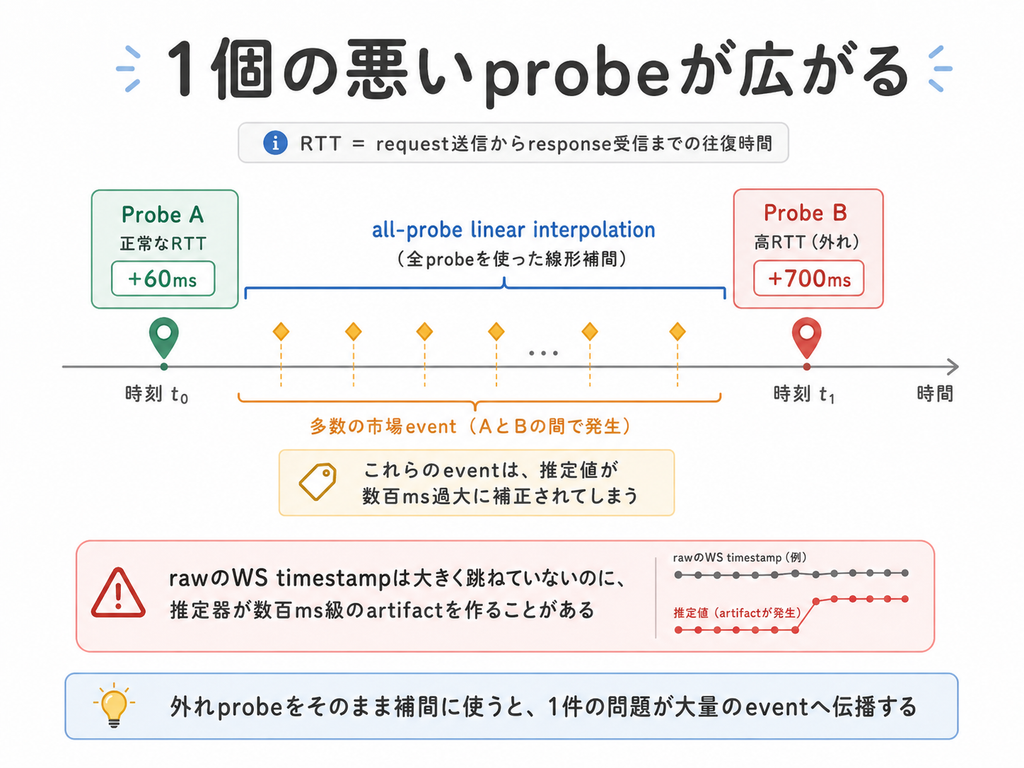
この往復時間がRTTです。
普段は数十ms程度なのですが、ときどき大きなRTTが混ざります。
ある観測では、高RTTのprobeを含む値をそのまま使って、前後の時計差を線形補間していました。
イメージとしては、
t=0秒 clock offset +60ms
t=60秒 clock offset +700ms
という2点があれば、
その間を、
+60
+200
+300
+400
+500
+600
+700ms
のように滑らかにつなぐ感じです。
ところが、後からraw dataを監査してみると、
+700ms側のprobeはRTTが大きく、clock offsetの推定値として不確実性が高い測定だった
ことが分かりました。
さらに厄介なのが、線形補間です。
1個の怪しいprobeを単独の外れ値として残すだけなら、その1件だけの問題です。
でも、その値を補間の基準点として使うと、
その前後に存在する大量のmarket eventにも、間違った時計差を割り当ててしまいます。
実際、
rawのWebSocket timestamp自体には大きな異常がないのに、
補間後の値だけが数百ms、場合によっては秒単位まで跳ねる現象が確認できました。
つまり、
市場データがおかしかったのではなく、時計差を推定するロジック自身がartifactを作っていた
わけです。
高RTTのprobeをどう扱うか
そこで、server-time probeを全部同じ信頼度で扱うのをやめました。
採用した候補のひとつが、
LOW_RTT_Q25
という方法です。
QはQuantile、分位点です。
たとえば15分間でserver-time probeを30回取ったとします。
その30件をRTTが小さい順に並べて、
成功したserver-time probeのうち、RTTが小さい側25%を選び、そのclock offset estimateの中央値をrun全体の代表値として使う
という考え方です。
30件なら8件ほどです。
その8件について、
「Binance時計とローカル時計がどれくらいズレているか」
を計算し、その中央値をrun全体の代表値として使います。
重要なのは、
残り75%を「間違ったデータ」として削除しているわけではない
という点です。
すべてrawとして保存します。
ただ、
「時計差を測る物差しとしては、RTTの小さいprobeの方を優先する」
というだけです。
この方法を既存データで見つけたあと、新しい15分runでも事前にルールを固定して検証しました。
結果として、以前のような数百ms〜秒単位の人工的なjumpは出ませんでした。
なお、低RTTの測定を優先する考え方自体は、今回独自に発明したものではありません。時刻同期ソフトウェアのchronyにも、RTTが小さい側のquantileを使って測定を選別する
maxdelayquantという仕組みがあります。今回のQ25はchronyそのものではありませんが、「長いRTTほどclock offset測定の不確実性が増えやすいので、低RTT側を優先する」という考え方は既存の時刻同期技術とも整合しています。
ここまでで、
「とりあえず時計問題はかなり整理できたかな」
と思っていました。
でも、途中で別の疑問が出てきました。
そもそも、私は何の時刻を知りたいんだ?
今回、一番大きかったのはここです。
私は以前、かなり高頻度で板に張り付いて取引するbotを作っていました。
その経験もあって、
時刻はできるだけ正確に合わせるべき
という方向へ自然に思考が寄っていたのだと思います。
もちろん、数msや数十msを競うなら重要です。
でも今回作っているものは、そこまで高頻度の取引botではありません。
知りたいのは、
Binanceの変化を観測
↓
何秒か後
↓
Hyperliquidの変化を観測
というような、CEX–DEX間の価格伝播です。
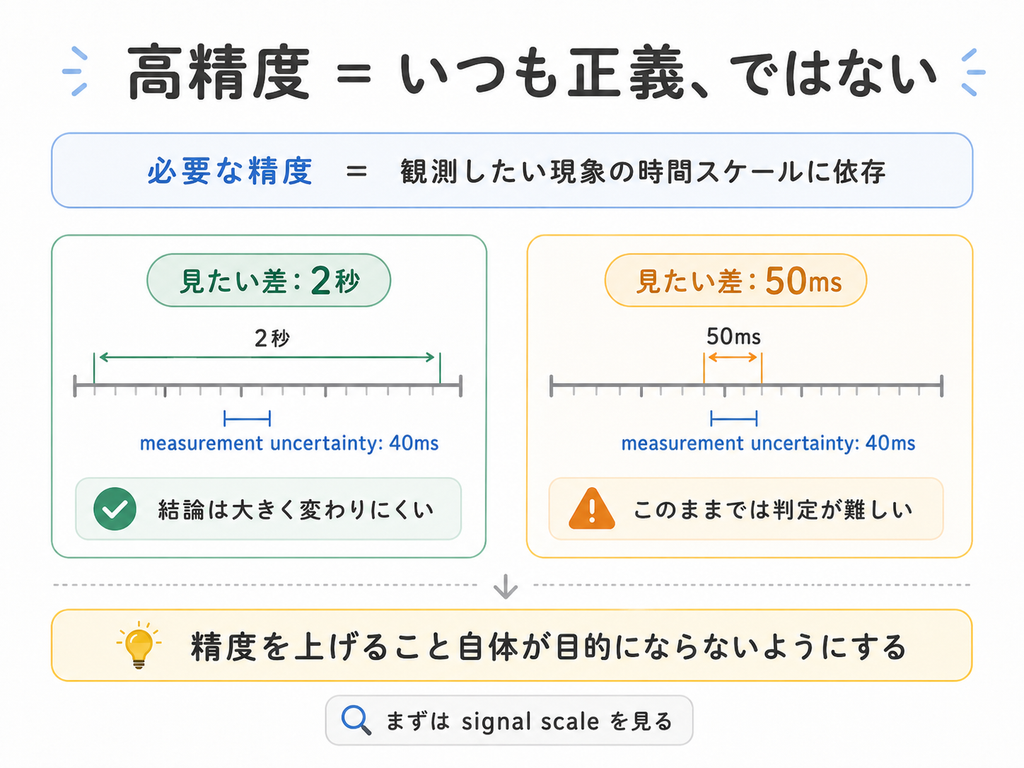
たとえば本当に2秒の差があるなら、
時計の不確実性が40msなのか20msなのかは、それほど重要ではありません。
逆に、観測してみて50ms程度しか差がないなら、
その時点で初めて、
「今の観測精度では足りない」
と考えればいい。
ここでようやく、
精度を高くすることと、その精度が本当に必要であることは違う
と気づきました。
「市場でいつ起きたか」より「自分にはいつ見えたか」
さらに考えてみると、botが実際に使える情報という意味では、
exchange側のtimestampより、
自分の観測機にいつ届いたか
の方が直接的です。
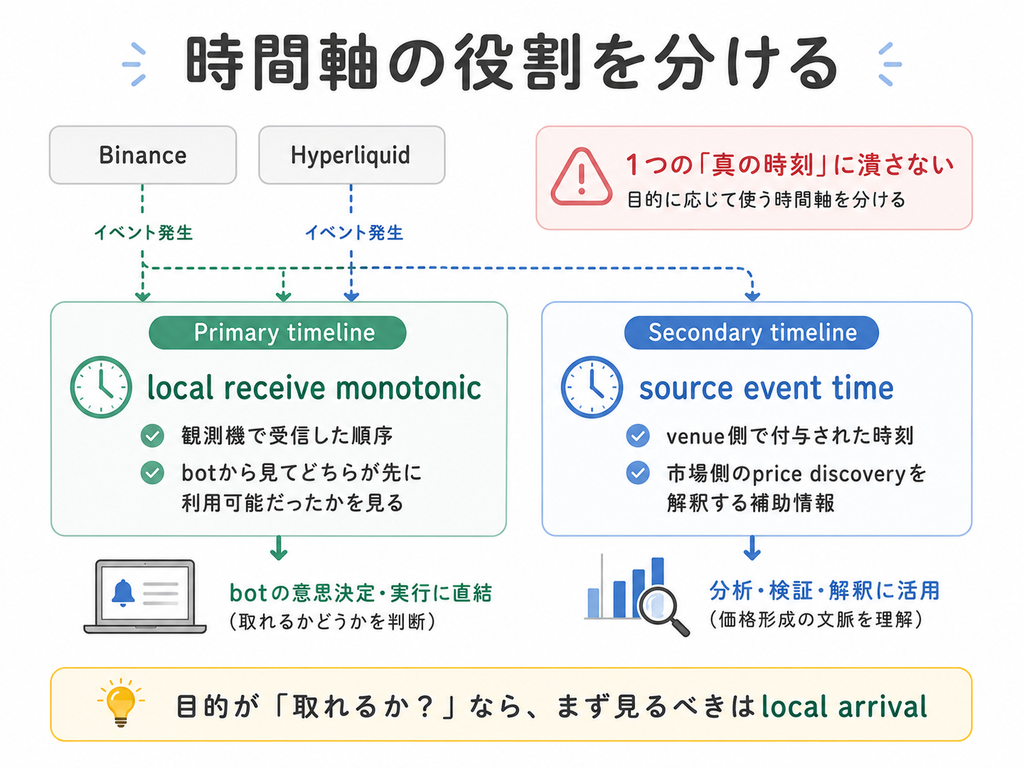
そこで今は、
Primary timeline
として
local_receive_monotonic_ns
つまり、
自分の観測地点でデータを受信した順序
を主軸にします。
一方で、
Secondary timeline
として、
- Binance側のevent timestamp
- Hyperliquid側のsource timestamp
もそのまま保持します。
これは、
「市場側ではどういう順序だった可能性があるのか」
を解釈するための補助情報です。
つまり、
Local arrival
→ botから見てどちらが先に利用可能だったか
Source event time
→ 市場側のprice discoveryを解釈する材料
と役割を分けました。
どちらか一方を「真のtimestamp」にするのではなく、
違う問いに答える2種類の時間軸として持つ
という設計です。
後から既存のmarket-data基盤も確認してみると、似た分離は普通に行われています。たとえばDatabentoはmarket側の
ts_eventとcapture側のts_recvを別々に保持し、ts_recvが存在するデータではsorting/indexingのprimary timestampとして使っています。また、publisher側timestampは補正せずoriginal valueを保持しています。
さらにPyth Proの資料でも、latency comparisonではsource timestampの絶対的な精度よりrelative timeが重要で、observer側ではprice streamをlocal receive timeで比較する、という説明がされています。今回のLocal-primaryへの切り替えは、後から調べるとこうした既存の実務的な考え方ともかなり近いものでした。
15分の同時観測でもcommon timelineは作れた
この方針に変更して、BinanceとHyperliquidを15分間同時に観測しました。
取得したeventは約9.7万件。
BinanceのbookTickerやaggTrade、Hyperliquidのtradeやl2Bookを、
同じローカルのmonotonic clock上で並べています。
このrunでは、
- monotonic timestampの欠損なし
- 時刻の逆行なし
- raw dataへの参照切れなし
- duplicate event IDなし
まで確認できました。
つまり少なくとも、
「自分の観測地点で、BinanceとHyperliquidのどちらを先に見たか」
を並べられるところまでは来ました。
次は24時間観測を回して、そのデータから実際に価格伝播を調べる予定です。
ようやく本来やりたかったところへ戻ってきました。
精度が高いほど良い、とは限らない
今回の開発を振り返ると、結構長いことtimestampを掘っていました。
それ自体が無駄だったとは思いません。
むしろ、
- exchangeとlocalの時計は違う
- source timeとreceive timeは別物
- timestamp fieldによって意味も違う
- network delayを含むprobeにも品質差がある
- 推定器自身がartifactを作ることがある
といったことを、実データを通して理解できました。
その上で、
「これ以上の精度は今の研究に本当に必要なのか?」
と判断できるようになった。
ここが大事だった気がします。
最初から、
「数十msなんて無視していい」
と言っていたら、それはただ雑なだけです。
今回の場合は、
数十ms程度の測定不確実性があることを実測で確認した上で、それより十分大きな時間スケールをまず研究する
という判断です。
これは意味が違います。
必要な精度は、目的から逆算する
今回の話はbot開発以外にもかなり一般化できそうです。
たとえば、
- データをもっと細かく取る
- backtestをもっと現実に近づける
- シミュレーションをもっと精密にする
- ログをもっと増やす
- モデルをもっと複雑にする
といった改善は、基本的には精度を上げる方向です。
でも、
その改善によって最終的な判断が変わるのか
は別の話です。
2秒の差を見たいのに、40msの誤差を10msへ縮めるために何日も使う。
それで研究結果が変わらないなら、限界効用はかなり低い。
逆に50msの差を研究したいなら、40msの不確実性は大問題なので、そこへリソースを割く価値がある。
必要な精度は、
観測したい現象の大きさから逆算する
ということですね。
当たり前と言えば当たり前なのですが、実装していると局所的な問題を解くこと自体が目的になってしまうことがあります。
今回はまさにそれでした。
過去の成功パターンが、今の最適解とは限らない
もうひとつ個人的に面白かったのは、過去の経験に引っ張られていたことです。
以前の高頻度botなら、
「もっと正確に」
という方向へ進むのはかなり自然でした。
でも今回は研究対象が違います。
同じbot開発でも、
求められる観測精度も、データの扱い方も、優先すべき設計も変わる。
過去にうまくいった思考モードをそのまま持ち込めばいいわけではない。
途中で、
「そもそも今、何が見たいんだっけ?」
まで戻ったのは結構大きかったです。
今回のまとめ
今回の開発で改めて感じたのは、
精度の高さと、目的に対して十分な精度であることは違う
ということでした。
正確さを追うこと自体が悪いわけではありません。
ただ、
その精度によって何が判断できるようになるのか
その判断は今の研究に必要なのか
を途中で確認しないと、精度を上げること自体が目的になってしまいます。
今回、timestamp問題をかなり掘ったからこそ、
「今の目的ならここまでで十分」
と止められたとも言えます。
次はいよいよ24時間の観測です。
BinanceとHyperliquidを同じローカル時間軸に並べて、
本当にどちらが先に見えて、どれくらい後からもう片方が追ってくるのか。
ようやく本題を見にいきます。
それでは、また。
ちなみに、BinanceとHyperliquidのlead/lag自体はすでに既存研究・分析があります。Arrakis Financeは29銘柄のperpetual市場を対象にlead-lagを分析し、Binance→Hyperliquidで概ね600〜800ms付近のlagを報告しています。独立研究でもBinance–Hyperliquidのprice discoveryをvenue event timeで比較した例があります。今回の研究では、これらをそのまま再現するというより、「自分の観測地点で何が先に利用可能だったか」というlocal-arrival側からも確認していく予定です。
今回のようなtimestamp問題を扱った記事も見つかったので、リンク貼っておきます。
LeadEdge — Cross-exchange ETH lag API(Indie Hackers)
Tardis.dev Timestamp Normalization & Cross-Exchange Data Alignment