こんにちは、よだかです。
最近、AIを使ったエッジ探索の進め方が少し変わってきました。
以前よりも、候補を探す、資料を読む、類似事例を比較する、コントラクトや取引を確認する、といった作業そのものはかなり速くなっています。コードを書いて簡単な検証を行うところまで含めても、以前よりずっと低いコストで進められます。
一方で、別の問題が目立つようになりました。
調べられることが増えすぎてきた。
一つのテーマを調べると、そこから関連する事例や別の仮説が次々に出てきます。全部を深掘りしていると、研究時間はいくらあっても足りません。
そこで今回は、新しいエッジ候補を調べる際に、候補を広く拾う工程と、一つの候補を深く検証する工程を明確に分けてみました。
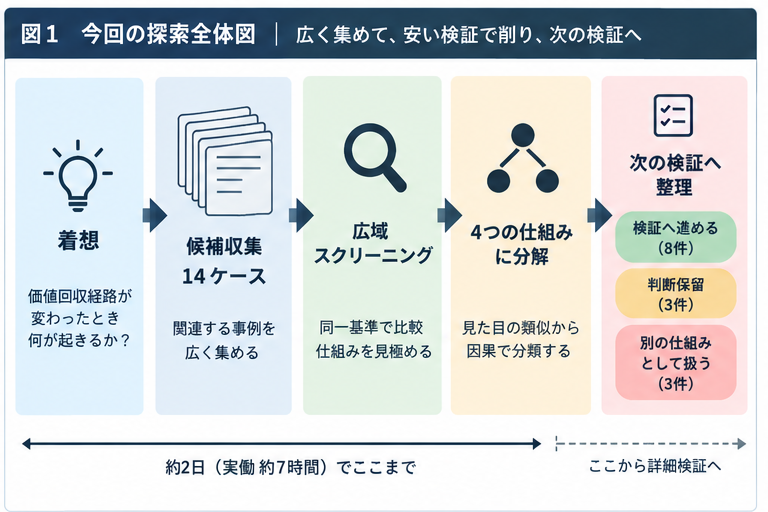
結果として、最初の着想から14ケースの広域スクリーニングを終え、4種類の仕組みに分解し、それぞれを「次の検証へ進める」「判断保留」「別の仕組みとして扱う」に整理するところまで、約2日で進めることができました。実際に作業していたのは午前中が中心なので、合計すると7時間前後です。
ただし、ここでエッジが確認できたわけではありません。
現時点では、取引サイズを考慮した採算性、純利益、後知恵なしで個人botが取得できたか、同じ仕組みが反復するか、といった部分は未検証です。今回完了したのは、あくまで候補空間を広げて、次に何を確認すべきか分かる状態まで圧縮する工程です。
【今回の探索全体図】
1.出発点は「価値へ戻る経路が壊れたとき、何が起きるか?」
今回の出発点は、最初から完成されたエッジ仮説ではありませんでした。
かなり大雑把に言えば、
トークンやブリッジ資産について、裏付け・償還・価値回収経路の状態が変わったとき、市場や別のプロトコルとの間にズレが生じないか
という観測視点です。
そこから、ブリッジ資産の価値崩壊、担保評価、償還停止、部分回収、裏付け不足、外部への換金経路など、見た目が近い事例を広く集めました。
重要なのは、最初から「これらは全部同じ仕組みだ」と考えなかったことです。
以前の研究では、見た目が似ていることを理由に仮説を広げすぎ、「似ている」と「同じ因果関係」を混同したことがありました。
今回も、最初は一つの大きな観測レンズとして候補を集めましたが、事例を当てていく中で、実際に利益が生じ得る仕組みはかなり異なることが分かってきました。
関連記事:
🛠️開発記録#571(2026/9/16) 仮説を広げすぎた話|「似ている」と「同じ仕組み」を混同した
2.事例を広げると、4つの別の仮説に分かれた
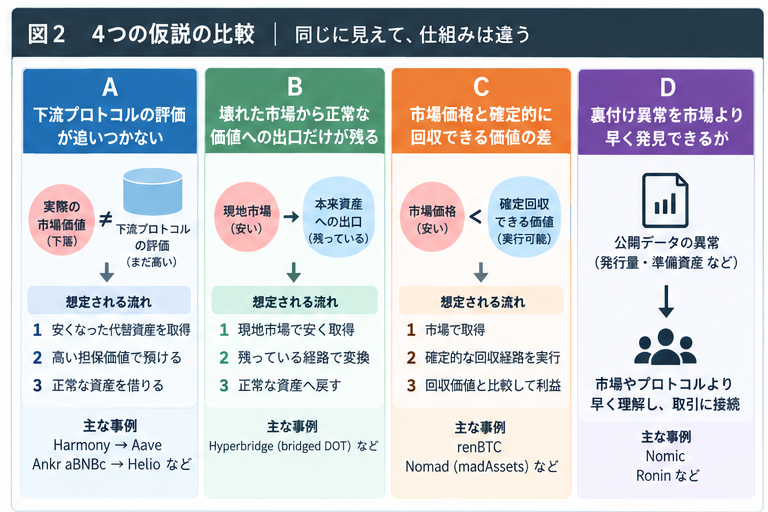
14ケースを比較した結果、現在は大きく4種類の仕組みに分けています。
これは最初から用意していた分類ではありません。事例を確認し、「同じ仕組みとして扱ってよい範囲」を削っていった結果として残ったものです。
仮説A:下流プロトコルの評価が追いつかない
一つ目は、実際の市場価値が壊れた資産を、別のプロトコルがまだ元の価値で評価してしまうケースです。
例えば、あるブリッジ資産が現地市場では大幅に値下がりしているのに、貸付プロトコルでは元の資産価格に近い担保価値が付いたままだとします。
この場合、
安くなった代替資産を取得 → 高い担保価値で預ける → 正常な資産を借りる
という経路が成立する可能性があります。
この仕組みには、少なくとも「代替資産の価値や裏付けが壊れる」「下流側の評価がそれを即座に反映しない」「預入・借入などの経済経路がまだ開いている」という3条件が必要です。
今回の候補では、HarmonyからAave、AnkrのaBNBcからHelioといった事例がこの構造にかなり近く、事前に経路を閉じていたAave Fantom側の事例も対照として残りました。
現時点では、4つの仮説の中では最も支持が強く、広域スクリーニング上はSUPPORTEDと整理しています。
仮説B:壊れた市場から正常な価値への出口だけが残る
二つ目は、現地市場では代替資産が安くなっているのに、本来の資産へ戻る経路だけはまだ生きているケースです。
概念的には、
現地市場で安く取得 → 残っているブリッジ・償還経路を利用 → 正常な本来資産へ変換
となります。
ここで重要なのは、単なる価格崩れではないことです。
今回、Hyperbridgeのbridged DOTはこの構造に合いました。一方、Acala aUSDやAllbridge Coreにも事故後の価格差はありましたが、利益実現に「代替資産固有の償還経路」は必要ありませんでした。
そのため、この2件は同じ仮説に押し込まず、一般的な事故後の裁定やプール不均衡として別枝へ移しました。
Family B全体としては、現時点ではMIXEDです。
仮説C:市場価格と「確定的に回収できる価値」の差
三つ目は、市場価格と、その時点で実際に確定できる回収価値との差です。
ここでは「大幅に安いから買う」という発想は採りません。
比較するのは、
市場価格
と、
現在実行可能で、条件を固定できる回収価値
です。
例えばrenBTCでは、新規mintが止まった後もしばらくburnからnative BTCへ戻る経路が残っていました。一方、NomadのmadAssetsでは、既に回収されていた比例配分部分だけが確定回収価値になり得ます。
逆に、soBTCやsoETHはFTX経由のnative BTC・ETHへの出口が失われていました。価格が大幅に下落していても、比較対象となるhardな回収価値がないので、これは裁定というより破綻債権に近い価格形成です。
つまり、
期待回収額と、確定回収価値は別物です。
このFamilyも現時点ではMIXEDとしています。
仮説D:裏付け異常を市場より早く発見できるか
四つ目は少し性質が違い、価格差より情報差が中心です。
代替資産の発行量と実際の裏付け資産が一致していない状態がpublic dataに現れている場合、それを市場やプロトコルが認識するより早く第三者が発見できれば、情報優位になる可能性があります。
ただし、
異常なデータが公開されていた
ことと、
その意味を後知恵なしで理解できた
ことと、
その情報を実際の売買へ接続できた
ことは別です。
Nomicでは異常な供給増加などは公開情報として存在していましたが、そこから裏付け不足まで理解するには、複数chainの状態やreserve構造を正しく結び付ける必要がありました。
Roninではreserve outflow自体はかなり直接的でしたが、それを第三者が実際に利益化できたかはまだ確認していません。
したがって、このFamilyは現時点ではPARTIALです。
【4つの仮説の比較図】
3.まず広く見る。深く調べるのはその後
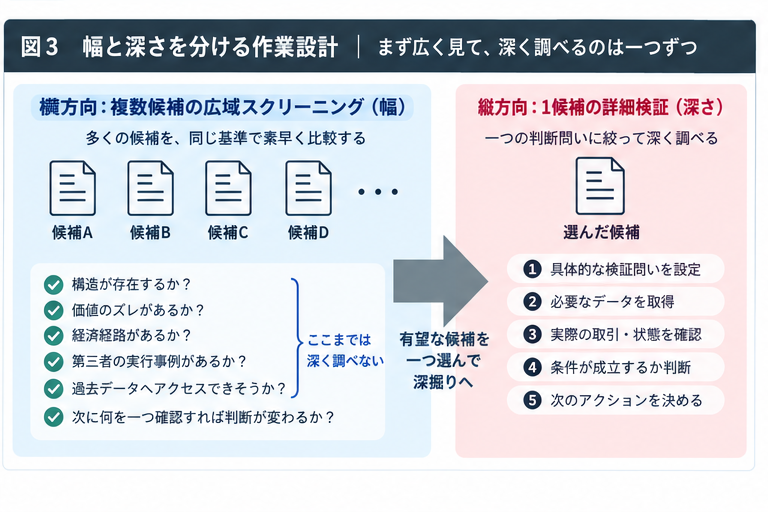
今回かなり効いたのが、候補を広げる工程と、一つの候補を深く調べる工程を分けたことです。
私は現在、
幅はまとめて、深さは一問ずつ
くらいに考えています。
広域スクリーニングでは、構造が本当に存在するか、価値のズレがあるか、経済経路があるか、第三者の実行事例があるか、過去データへアクセスできそうか、次に何を一つ確認すれば判断が変わるか、というところまでを見ます。
ここでは、いきなり純利益やMEV競争、全取引履歴の再構築までは進みません。
一方、一つの候補を深く検証する段階では、「今回の作業で何を一つ判断するのか」をかなり狭くします。
この分離をしないと、一つの事例を調べているうちに、wallet履歴、RPC、trace、価格、PnL、別protocolまで調査範囲が広がりやすくなります。
【幅と深さを分ける作業設計】
4.AIに「進め方」だけでなく「止まり方」を与える
AIを使った作業では、「何を調べるか」だけでは不十分でした。
何が分かったら止まるか。何が必要になったら勝手に先へ進まず、一度戻ってくるか。
ここを決めておく必要があります。
今回の具体例では、NomadからMoonwellへの影響を調べる中で、transfer pauseに関係すると思っていた候補取引を一件だけ確認しました。
ところが、実際に中身を読むとpause操作ではなく、Safeのowner管理に関する取引でした。
以前なら、そのまま別の候補取引を探し始めていた可能性があります。
今回は、
候補取引は違った → 正しいpause取引はまだ不明 → ここで保留
として止めました。
この時点ではnegative control仮説自体を否定できたわけではありません。単に「今回選んだ候補取引が違った」と分かっただけです。Baselineでも、その区別を残しています。
ここで感じたのは、探索の高速化とは「正解へ早く進むこと」だけではないということです。
間違った枝を、安く切る速度もかなり重要です。
以前の記事では、追加研究を続けるかどうかを「まだ分からない」ではなく、「次の追加作業で判断がどれだけ変わるか」で考えるようになった経緯を書きました。
今回の探索方法は、その考え方を複数候補の探索へ広げたものでもあります。
関連記事:
🛠️開発記録#570(2026/9/14)追加研究の限界価値を考える回:市場横断観測機の作成を通して
5.14ケースを調べて、8件を進め、3件を保留し、3件を別枝へ移した
広域スクリーニングの結果は、次のようになりました。
対象は14ケースです。
そのうち、次の限定的な検証へ進めるものが8件、具体的な不足証拠があり判断を保留したものが3件、元の仮説とは別の仕組みとして扱うものが3件でした。
Baseline上では、
PROMOTE 8 / HOLD 3 / RECLASSIFY 3
です。
ここで注意したいのは、PROMOTEが「エッジ確認」を意味しないことです。
PROMOTEは、
次の限定的な検証を行えば、現在の判断が大きく更新される可能性がある
という意味で使っています。
HOLDは、「弱い候補」ではありません。何が不足しているのかを具体的に特定したうえで、証拠待ちとして止めている状態です。
RECLASSIFYも失敗ではありません。
むしろ今回かなり重要だったのは、見た目の似た事例を無理に一つの仮説へ残さなかったことです。
Acala、Allbridge、soBTC/soETHは、それぞれ調査対象として意味はありますが、今回想定していた仕組みとは異なるため別枝へ移しました。
これは、仮説を守るために事例を集めるのではなく、事例を使って仮説の適用範囲を削ったということです。
6.約7時間で、どこまで進んだのか
今回、最初の着想から広域スクリーニングを終えて、14ケースを同一基準で比較できる状態まで持っていくのに約2日かかりました。
ただし、午前中の作業が中心なので、実働では7時間前後です。
この間に他の作業もかなり行っているので、正確な時間計測ではありません。
また、7時間で8件のエッジを発見したわけでもありません。
進んだのは、
着想 → 候補展開 → 事実確認 → 仕組みの分解 → 状態分類 → 次の判断問いまでの圧縮
です。
現時点でも、機会の発生頻度、典型的な継続時間、取引可能量、スリッページ、純利益、競争、個人botでの取得可能性、反復性など、多くの問いが残っています。
それでも、従来の自分の研究速度と比べると、体感では10倍近く速くなっている感覚があります。
これは外部benchmarkではなく、あくまで自分の過去の進め方との比較です。
そして、速くなった理由を「AIが検索やコード生成をしてくれるから」だけで説明するのは少し違うと考えています。
7.速くなった理由は「生成」より「収束」にあった
AIを使うと、候補を広げること自体はかなり簡単になります。
むしろ問題は、その後です。
候補が増え、関連事例が増え、調べられることが増えるほど、研究は簡単に発散します。
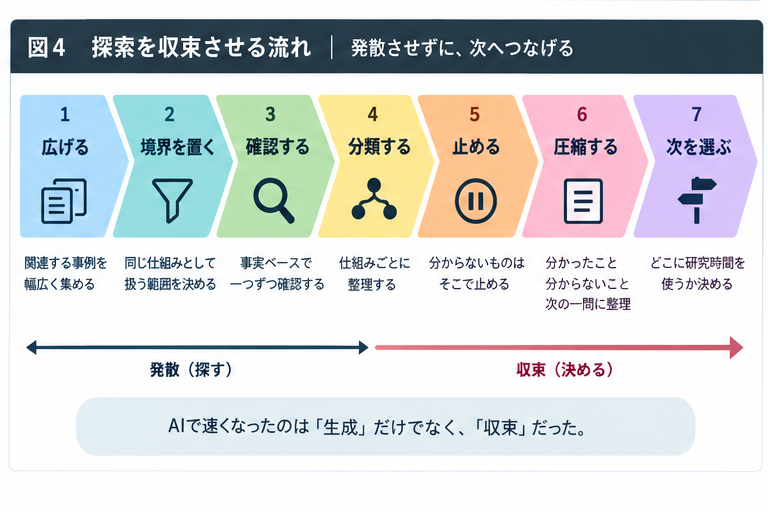
今回かなり意識したのは、
広げる → 境界を置く → 確認する → 分類する → 止める → 圧縮する → 次を選ぶ
という流れでした。
特に重要だったのは「圧縮」です。
AIを使うと成果物は簡単に増えます。
調査レポート、JSON、コード、取引データ、メモが積み上がり、それ自体が理解負債になります。
そこで一巡したところで、14ケースについて、
何が分かったか/何が分からないか/なぜ止まっているか/次に何を一つ確認するか
だけを、一つの基準表へ圧縮しました。
すると、「大量に調べた」という状態から、「次にどこへ研究時間を使うか判断できる」状態へ戻せます。
【探索を収束させる流れ】
8.「次へ進める」と「botを作る」は違う
今回、次の検証へ進める候補は8件残りました。
しかし、8件すべてについてbotを作るわけではありません。
次に必要なのは、例えば特定の取引を一件確認する、特定時点のstateを読む、確定回収価値を一件確認する、public dataから本当に異常が見えていたかを確認する、といった限定的な作業です。
そこで条件が崩れれば終了します。
逆に、構造が確認できても、利益が薄い、機会が短すぎる、競争が激しい、監視コストが高いのであれば、実装しないこともあります。
以前GHOの裁定候補を調べたときも、「見えた」「取れそう」というところまでは進みましたが、最終的には実装しない判断をしました。
関連記事:
🛠️開発記録#575(2026/9/20)見えた、取れそう、それでも取らない|GHO裁定を実装しなかった理由
9.エッジを見つける技術ではなく、探索を管理する技術として残す
今回残しておきたいのは、「償還状態を見ればエッジが見つかる」という話ではありません。
現時点では、そのような共通edgeは確認できていません。
むしろ残したいのは、
候補を十分広く持ち、安い確認で仕組みを分け、次に判断を変える一問まで戻す
という探索方法です。
AIを使うことで、調査・実装・比較の速度はかなり上がりました。
一方、それによって「何でも調べられる」という別の問題も生まれました。
そのため、AIに任せる範囲を広げるだけでなく、
何をまだ調べないか、どこで止めるか、どの時点で情報を圧縮するか
まで含めて設計する必要があります。
これは今回のエッジ探索だけで普遍的な方法だと証明できるものではありません。
ただ、他の研究や開発でも似た問題は何度も起きています。
少なくとも現在の自分にとっては、AIを使ったアルゴトレード研究を進めるうえで、かなり重要な技術の一つになりつつあります。
エッジ探索では、「何を調べるか」だけでなく、何をまだ調べないかを決めることも技術になる。
今回は、その方法を一度整理して残しておくことにしました。
それでは、また。