こんにちは、よだかです。
ここ数日、DeFiの清算市場を対象に、新しい取引機会の検証を進めています。
過去の取引や市場状態を調べる中で、利益につながる可能性のある構造が見つかりました。複数の過去事例を使った検証でも、その仕組みが実際に成立していたことを確認できています。
もちろん、これは現在の市場で利益を得られると証明できたわけではありません。次に必要なのは、その状態変化を実際の市場で事前に把握できるのか、ほかの参加者より早く行動できる余地があるのかを確かめることです。
そこで、発注を行わずに市場を観測する仕組みを作り、24時間の継続観測を試みることにしました。
ところが、ここから思わぬところで詰まりました。
データを取得するサービスの選定、ブロックチェーン上の状態取得、通信切断からの復旧、エラーの判定、停止条件の設定。
一つ問題を解消すると別の問題が表面化し、観測プログラムを十分な時間動かすこと自体に、予想以上の手間がかかっています。
この記事を書いている時点でも、予定していた24時間の連続観測は完了していません。
ただ、この過程で重要なことに気付きました。
取引上の優位性を生む構造を見つけることと、その構造を継続的に観測できることは、別の問題だったのです。
今回は、この数日間の開発で何が起き、どのように認識が変わったのかを整理します。
なお、研究中の具体的な清算条件や対象市場、取引経路については公開を控えます。ここでは、観測インフラの技術的な問題と、研究方法の見直しに焦点を当てます。
1.エッジ候補の発見は観測の成立を保証しない
これまでのDeFi研究では、利益が生まれ得る構造を見つけた後、その構造が実際に動いているかを確かめ、取引できる条件が揃っているかを評価してきました。
以前の開発記録#580「エッジはどこで消えるのか」でも、構造的な価格差が存在することと、個人が実際に利益を得られることは別だと書いています。
手数料や流動性によって利益が消えることがあります。
利益が存在しても、ほかの参加者が先に回収してしまうこともあります。
今回は、さらにその手前に別の問題があることを実感しました。
そもそも、その機会が発生する瞬間を、自分の観測環境で把握できるとは限らないのです。
過去データの検証では、すでに起きた出来事を調べられます。
どの時点で市場状態が変化し、どの取引が行われ、その前後に何が起きたのか。必要な履歴にアクセスできれば、時間をかけて再構成できます。
しかし、実際の取引に近づくためには、まだ起きていない状態変化を、その時点で利用できる情報だけから判断しなければなりません。
過去の結果を知ってから計算できたことと、結果が出る前に計算できたことは違います。
だからこそ、今回は実市場での継続観測へ進みました。
研究の方向性としては自然な流れだったと思います。
ただし、その観測環境を成立させるための条件を、十分に把握していませんでした。
2.Robinhood Chainの高速ブロックは観測の時間感覚を変える
今回の研究対象となったチェーンは、Robinhood Chainです。
Robinhood Chainは、Ethereumを基盤とするレイヤー2のブロックチェーンで、Arbitrum系の技術を利用しています。
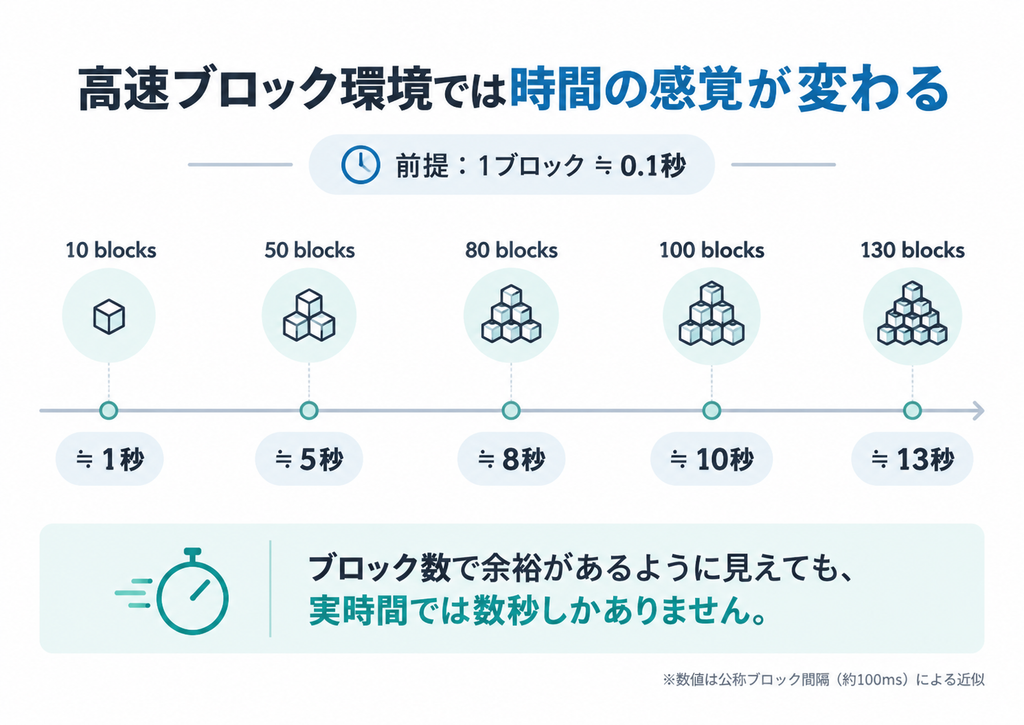
公式サイトでは、約100ミリ秒、つまり0.1秒のブロック生成間隔が特徴として紹介されています。
この数字は、実際に観測プログラムを動かしてみると、かなり重要でした。
例えば、1ブロックが約0.1秒なら、50ブロックは約5秒、100ブロックでも約10秒に相当します。
ブロック数だけを見ると十分な余裕があるように思えても、実時間では数秒しかありません。
【100msブロックと状態取得の時間幅】
今回の観測では、複数の情報を同じブロックの状態として取得する必要がありました。
例えば、担保の評価と借入残高を別々の時点から取得すると、実際には同時に存在しなかった組み合わせで計算してしまう可能性があります。
そこで、ブロックのハッシュを指定し、同一時点の状態を読み出す方式を使っています。
この方法自体はEthereumの技術仕様で定義されており、特別に珍しいものではありません。
問題は、同じブロックを指定して問い合わせられることと、そのブロックの状態をデータ提供元がいつまで保持しているかは別だということです。
今回利用した環境では、少し古くなった状態を取得できなくなる場面がありました。
逆に、新しいブロックの通知が届いた直後、そのブロックを指定した状態取得が一時的に失敗する場面もありました。
後者については、通知と状態取得を処理する側の同期差が原因として考えられますが、提供元内部の原因までは確定できていません。
いずれにしても、ブロックチェーンの仕様だけを把握していれば十分というわけではありませんでした。
チェーンの時間的な性質と、データを提供するRPCサービスの性質を組み合わせて考える必要があったのです。
ここは、今回の研究で明確に見落としていた部分でした。
3.通信・履歴・実装の問題が順番に表面化した
実際の開発では、いくつもの異なる問題が発生しました。
最初に詰まったのは、RPCサービスの選定です。
RPCとは、ブロックチェーンの状態や取引履歴を外部から問い合わせるための通信窓口です。
最初に利用したサービスでは、観測プログラムの通信量が無料利用枠に対して大きくなりすぎました。
別のサービスも試しましたが、必要な状態取得が安定して完了しない問題がありました。
その後、公開RPCサービスのPublicNodeを利用し、実際に状態取得と事前予測を動かせるようになりました。
ここまでは改善です。
ところが、今度は通信と復旧に関する問題が続きました。
まず、ブロックを指定した状態取得でエラーが発生し、観測が停止しました。
次に、その問題への対処を進めたところ、常時接続して新しいブロックやイベントを受け取るWebSocket通信が切断され、再接続せずに停止していたことが分かりました。
再接続を整備すると、今度は受信メッセージに想定していた項目がなく、プログラムの例外処理で停止しました。
さらに復旧処理を進める中では、共有状態の切り替え時に例外が発生し、不要な再接続につながる問題も見つかりました。
その復旧処理では、取り逃した過去のイベントを再取得しようとして、PublicNodeからHTTP 403の応答を受けています。
応答本文は、次のものでした。
Archive requests require a personal token
過去のデータを取得するには、専用の認証情報が必要だという内容です。
これは単純にリクエスト数が多すぎたという証拠ではありません。
通常の観測に使えるRPCサービスであっても、障害復旧に必要な過去データの取得まで、同じ条件で利用できるとは限らなかったわけです。
【今回の停止原因を技術的な層ごとに分類した図】
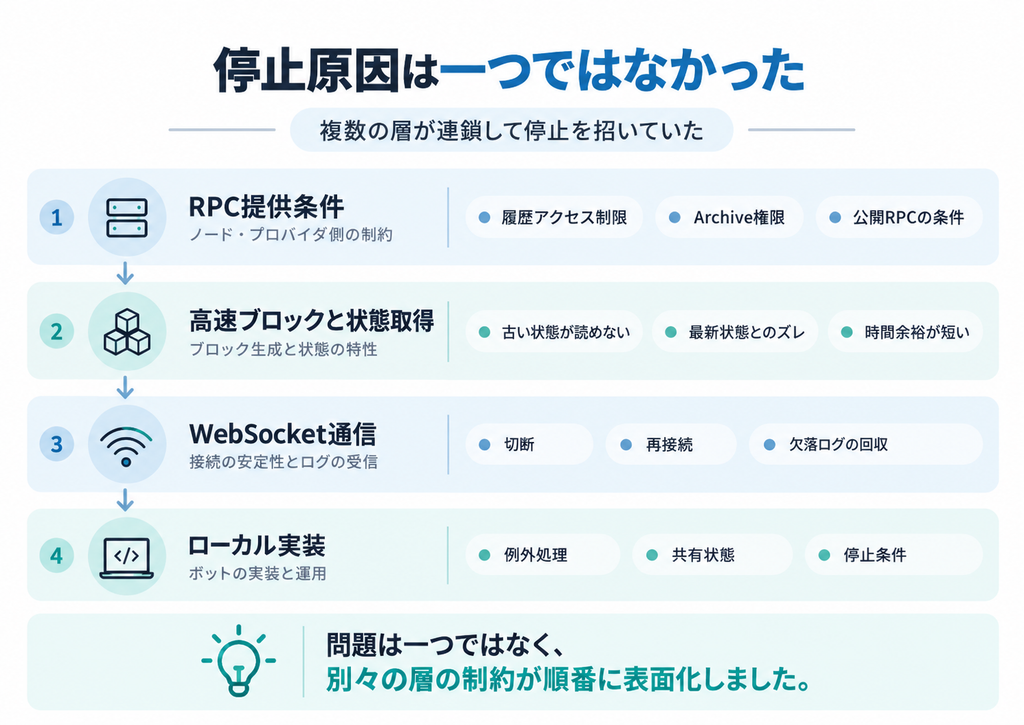
ここまで並べると、ずいぶん多くの問題が発生したように見えます。
実際、その通りです。
ただし、これらをすべてRobinhood ChainやPublicNodeの問題とするのは正確ではありません。
データ提供元の制約もありましたが、ローカル実装の不備もありました。
通信上の一時的な問題に対し、観測プログラムが過剰に反応していた部分もあります。
そして、後から振り返ると、そちらの方が開発を長引かせた大きな要因だったと考えています。
4.データを棄却することと観測を止めることは別である
今回、特に大きな認識の更新があったのは、観測プログラムの停止条件です。
研究用の観測プログラムでは、誤ったデータを証拠として採用しないことが重要です。
取得した状態に不整合があるなら、そのデータを使って予測を作るべきではありません。
必要な情報が欠けているなら、その区間を有効な観測として扱うべきでもありません。
ここまでは正しい考え方です。
しかし、開発を進める中で、データを有効と認めないことと、観測プログラム全体を停止することを混同していました。
例えば、通信が一度途切れた場合を考えます。
その瞬間の情報が取得できていなければ、関連する予測を無効にし、取得できなかった区間を未確認として記録する必要があります。
ただし、通信が復旧して新しい市場状態を正常に取得できるのであれば、そこから観測を再開できます。
取り逃した数秒間を、観測できたことにしてはいけません。
一方で、その数秒間を取得できなかったことだけを理由に、残りの23時間の観測まで諦める必要はありません。
今回の初期実装では、一時的な通信障害やデータ取得エラーが、プログラム全体の停止につながりやすい設計になっていました。
監査すると、全体停止につながり得る名前付きのエラー分類が42種類あり、15系統に分かれていました。
これは42個の独立した停止条件が存在したという意味ではありませんが、さまざまな局所的な失敗が、共通の停止処理へ伝播する構造になっていました。
そこで、停止条件を整理し直しました。
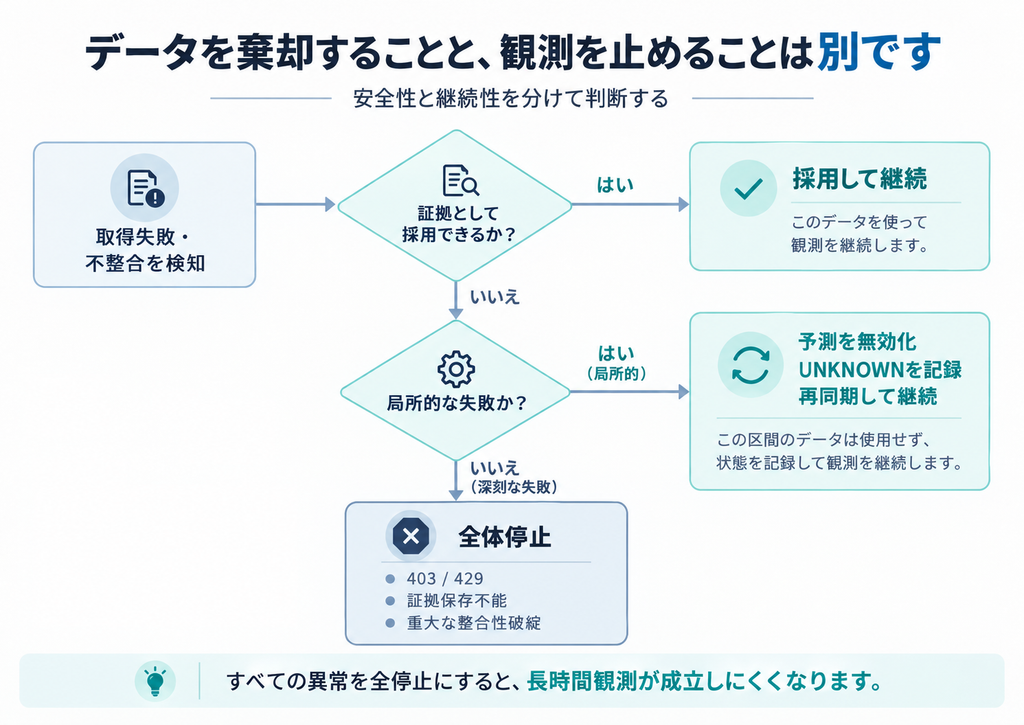
現在は、通信の一時的な失敗と、全体を止めなければならない重大な問題を分離しています。
通信の失敗や欠測は記録し、必要なら予測を無効化して再同期します。
一方、利用制限による明示的なアクセス拒否、通信予算の超過、証拠を保存できない障害、観測対象の重大な不整合などは、全体停止の対象として残しています。
【データの有効性・復旧・全停止を分離する判断フロー】
この変更によって、今後どの程度安定して継続観測できるかは、まだ検証中です。
しかし、設計上の考え方は以前より明確になりました。
観測できなかったことを正しく記録する能力と、観測を継続する能力は両立できる。
むしろ、長時間の市場観測では、その両方が必要なのだと思います。
5.既存の観測インフラは別のチェーンでそのまま使えるとは限らない
今回、もう一つ見落としていたことがあります。
それは、過去に作った観測インフラを、どこまで別の研究に流用できるのかという問題です。
これまでにも、複数の市場で継続的にデータを取得する仕組みを作ってきました。
例えば開発記録#587「PMF Radarの72時間観測と追加検証」では、無期限先物市場の状態を約72時間収集し、観測品質や市場ごとの違いを分析しました。
こうした経験があったので、今回も既存の部品を使いながら観測器を組み立てれば、比較的スムーズに進められると考えていました。
実際、再利用できたものも少なくありません。
計算処理、過去データの検証方法、証拠の保存形式、取得結果の整合性確認などは、研究対象が変わっても使える部分があります。
一方、状態取得や通信の復旧については、そう単純ではありませんでした。
同じEthereum互換のチェーンでも、ブロック生成間隔は違います。
データ提供元によって、過去の状態やログを取得できる範囲も異なります。
通信が途切れた場合に、何をどこまで回復する必要があるかも、研究目的によって変わります。
さらに、今回のように予測と実際の取引の先後関係を調べたい場合、単に最新データを取得できればよいわけでもありません。
ここから、再利用についての考え方が変わりました。
再利用できるのは、完成した観測器そのものとは限りません。再利用できるのは、それぞれの部品と、その部品が正しく動作するための条件です。
例えば、あるブロックの状態を固定して取得する処理を再利用するなら、そのチェーンで必要な状態を何秒以内に取得できるか、利用するRPCがどの範囲まで対応しているかを確認する必要があります。
接続の復旧処理を使うなら、欠落したデータをどの方法で補えるかを確認しなければなりません。
これまで、共通化できる部品を増やせば新しい市場への展開が楽になると考えていました。
その方向性は変わりません。
ただし、部品の共通化と、動作条件の共通化は別です。
ここを切り分ける必要があると分かりました。
6.AIとの共同開発でも局所修正の積み重ねだけでは足りない
今回の開発では、AIとの共同作業についても考えさせられました。
AIは、個別の実装や検証では非常に役立っています。
エラーが出れば、その発生箇所を調べ、原因候補を整理し、修正案を作れます。
修正後の回帰テストを大量に実行し、過去の計算結果が変わっていないかを確認することもできます。
実際、今回もそうした作業によって、いくつもの問題を解消してきました。
しかし、振り返ると、開発の進め方そのものに問題がありました。
あるエラーで停止したら、そのエラーに対処する処理を追加します。
別のエラーが発生したら、また対応を追加します。
一つひとつの修正は合理的に見えても、全体として観測プログラムが複雑になり、研究の目的から離れていくことがあります。
今回がまさにそうでした。
特に、安全性を重視するあまり、さまざまな異常を全体停止につなげていました。
もちろん、誤ったデータを使って研究結果を出すことは避けなければなりません。
ただし、安全にすることと、できるだけ多くの条件で停止することは同じではありません。
この点は、AI側だけの問題ではありません。
私自身も、AIへの指示でデータの正当性や厳密な検証を強く求める一方、どの失敗まで許容して観測を続けるべきかを十分に整理していませんでした。
そのため、個別の修正と短時間の再検証を繰り返す流れになっていました。
以前、開発記録#554「AIと進めていたアルゴ研究を一度止めて、研究そのものを監査した話」では、AIが作った計算や研究結果を、自分自身が本当に理解できているのかという問題を取り上げました。
今回は、それとは少し違う問題です。
計算が正しいかどうかだけでなく、その計算を成立させるために、どこまで実装や検証を続ける価値があるのかを判断する必要がありました。
これは今回の事例から得た認識であり、AI一般が必ず同じ失敗をするという話ではありません。
ただ、少なくとも現在の私の開発体制では、目の前の問題を解く能力と、研究全体の目的に対して作業を最適化する能力を、同じものとして扱うべきではないと感じています。
実装が前進することと、研究判断が前進することは必ずしも同じではありません。
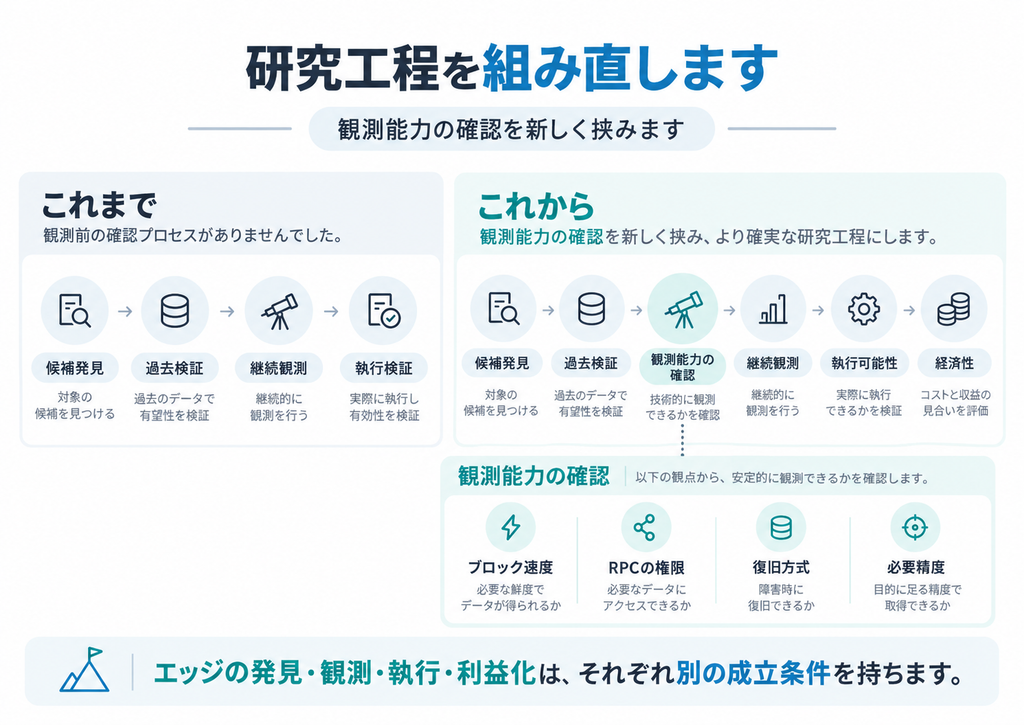
7.観測能力の確認を研究工程に組み込む
今回の経験を踏まえて、今後の研究の進め方も少し変えようと考えています。
これまでは、エッジ候補を発見し、過去データで検証し、継続観測へ進むという流れを比較的自然に考えていました。
もちろん、実際には対象によって手順を変えています。
ただ、過去検証から継続観測へ移る際に、その観測環境がどの程度の条件を満たす必要があるかを、十分に確認していなかった部分がありました。
今後は、その間に軽量な確認工程を置こうと思います。
確認したいのは、主に次のようなことです。
- 対象チェーンでは、どの程度の速さでブロックが生成されるか。
- 必要な状態や履歴を、利用予定のRPCから取得できるか。
- 通信が途切れた場合、何を回復できて何が未確認になるか。
- 研究目的に対して、どの程度の観測精度と継続時間が必要か。
ここで重要なのは、最初から完全な観測インフラを作ることではありません。
その研究に必要な観測が、現実的な費用と実装負担で成立する見込みがあるかを、早い段階で見極めることです。
【エッジ探索の研究工程の更新】
今回の24時間という設定も、特に強い統計的根拠があって決めたものではありません。
継続観測が成立するかを確かめ、その間に機会がどの程度出現するのかを見てみたい。
そのための暫定的な観測期間です。
24時間動かせば十分な数の機会が得られると分かっているわけではありません。
反対に、24時間の途中で通信が切れたからといって、それまでの有効な観測が無意味になるわけでもありません。
今後は、単にプログラムが何時間動いたかだけでなく、その間にどれだけ有効な情報を得られ、研究上の問いにどこまで答えられたかを重視したいと思います。
また、観測環境が整ったとしても、それで終わりではありません。
実際に取引するためには、注文をどの経路で送り、ほかの参加者との競争の中で実行できるのかを確かめる必要があります。
Robinhood Chainでは、公式ドキュメントで取引の到着順序を重視する設計が説明されています。こうした取引実行側の性質も、いずれ避けて通れません。
つまり、エッジの発見、継続観測、実際の執行、全費用を考慮した利益は、それぞれ別の成立条件を持っているということです。
今回、ようやくそのうちの観測という部分を、独立した問題として意識できるようになりました。
おわりに|24時間の完走は研究の目的ではない
正直なところ、ここまで観測インフラで詰まるとは思っていませんでした。
エッジ候補が見つかり、過去データでもその仕組みを再現できたところまでは、比較的順調でした。
そこから先は、実際の市場を観測しながら、機会がどの程度発生するかを調べる段階だと考えていました。
しかし、観測環境を作る中で、チェーン固有の時間的な性質、RPCの提供条件、通信復旧の難しさ、停止条件の設計といった問題が次々に出てきました。
結果として、かなりの時間を観測インフラの修復に使うことになっています。
ただし、その過程で得た知見もあります。
エッジの構造を理解することと、そのエッジを実際に観測できることは別です。
既存のプログラムが正しく動作していても、別のチェーンやデータ提供元で同じように動くとは限りません。
そして、観測データの厳密さを維持することと、観測プログラム全体を停止することは別の判断です。
今回の開発では、このあたりの前提をかなり見直すことになりました。
一方で、観測環境を完成させることそのものが目的になってはいけないとも感じています。
私が確かめたいのは、特定の市場構造が現在も利益機会を生んでいるのか、その機会を事前に認識できるのか、そして個人のbotで実際に取得できるのかということです。
24時間の継続観測は、そのための手段にすぎません。
必要以上にインフラを作り込むことも、逆に不十分な観測から都合のよい結論を出すことも避けたいところです。
今回の研究は、まだ途中です。
実市場で十分な頻度の機会が出現するかも、実際に利益を取得できるかも確認できていません。
それでも、今回の経験を通して、エッジを見つけた後に何を確認しなければならないのか、その理解は一つ進んだと思っています。
今後は、エッジの構造だけでなく、それを観測し、実行するための条件まで含めて、研究の優先順位を判断していくつもりです。
それでは、また。
参考資料・一次情報
今回の技術的な整理では、以下の公式資料を参考にしました。個別の停止事例やエラー発生状況は、自分の観測プログラムの実行記録に基づいています。
Robinhood Chain関連
- Robinhood Chain 公式サイト
チェーンの基本設計、Arbitrum基盤、約100msのブロック生成間隔。 - Robinhood Chain Documentation
チェーンの概要、Ethereum互換性、取引順序の基本方針。 - Connecting to Robinhood Chain
ネットワーク設定、RPC・WebSocket接続先、公開RPCの利用上の注意。 - Run a Robinhood Chain Full Node
ノード運用の基本条件、公開RPCと自前ノードの違い。
RPC・通信・状態取得関連
- PublicNode — Robinhood Chain RPC
今回利用した公開RPCサービス。通常の接続機能と、別途案内されているArchiveアクセス。 - Geth — Real-time Events
Ethereum系RPCにおける購読通知の一般的な仕組み、接続切断と通知欠落についての参考資料。 - EIP-1898 — Add blockHash to defaultBlock methods
ブロックハッシュを指定して、複数の状態取得を同一ブロックへ固定するための仕様。
※各RPC提供元の履歴保持範囲やアクセス権限は、ブロックチェーン全体の固定仕様ではありません。今回の実行時に確認した挙動と、公開資料に記載された一般仕様は区別しています。